上个月,微软在《科学》杂志上甩出一篇论文:自家AI诊断系统诊断正确率83%,对照组的全科医生只有36%。
微软AI CEO苏莱曼直言:这是通往「医疗超级智能」的一步。
热闹还没散,未来医生联合国内顶级三甲医院胸外科开展的一项多中心研究,也拿AI和医生比了一场,数字比微软的更亮眼。
考卷是顶级三甲医院胸外科拿出的40例真实疑难肺癌病例,从未公开过;20位顶级专家在看到任何答卷之前,先给每道题写好评分规则,答卷按满足规则的程度打分,满分100。
250名三甲医生自己做,平均53分。未来医生医疗大模型MedGPT(以下简称:未来医生MedGPT)做同一套题,85分。
再把两边的答卷按病例一对一摆在一起比:未来医生MedGPT对250名三甲医生的比分是88:12。而且AI的答卷,平均比医生的短了四成以上。
更有意思的是它赢的方式:和微软那套,正好相反。
先说考题。肺癌晚期合并间质性肺病,做过手术又复发,基因检测结果还没出来——这种病人,教科书没有标准答案,临床指南写到这里也得打个问号,全靠医生在「灰度区域」里拿经验做判断。
研究团队从100例复杂肺癌病例中,精挑细选出40例这样的「灰区」难题:
指南推荐不明确的、多种疾病与治疗限制相互冲突的、多因素交织导致标准路径走不通的,以及治疗先后顺序直接影响后续结果的。
20位多学科顶级专家先给每个病例定好参照标准:每例6条规则,共240条,每条都写死了什么条件下成立、什么条件下不算数,其中40条是安全红线,踩线直接判负。
对面坐的也不是全科医生。医生阵容,是来自98家医疗机构的250名三甲医院医生,六成以上是主任、副主任医师,胸外、呼吸、肿瘤三科。
在人机比较维度下,没有任何辅助的医生群体平均得分53.26,未来医生MedGPT直接交出了85.29。
同一道病例一对一比,在与医生无辅助条件下提交的750份诊疗方案的比较中,未来医生MedGPT有660次获得更高评分,以88比12战胜了250名三甲医生。——而且它的答卷平均比医生的短了四成以上!
放到模型横评维度里,未来医生MedGPT综合评分96.22,而GPT-5.4得分71.38,Claude Opus 4.7得分61.81,Gemini 3.1 Pro得分54.62。
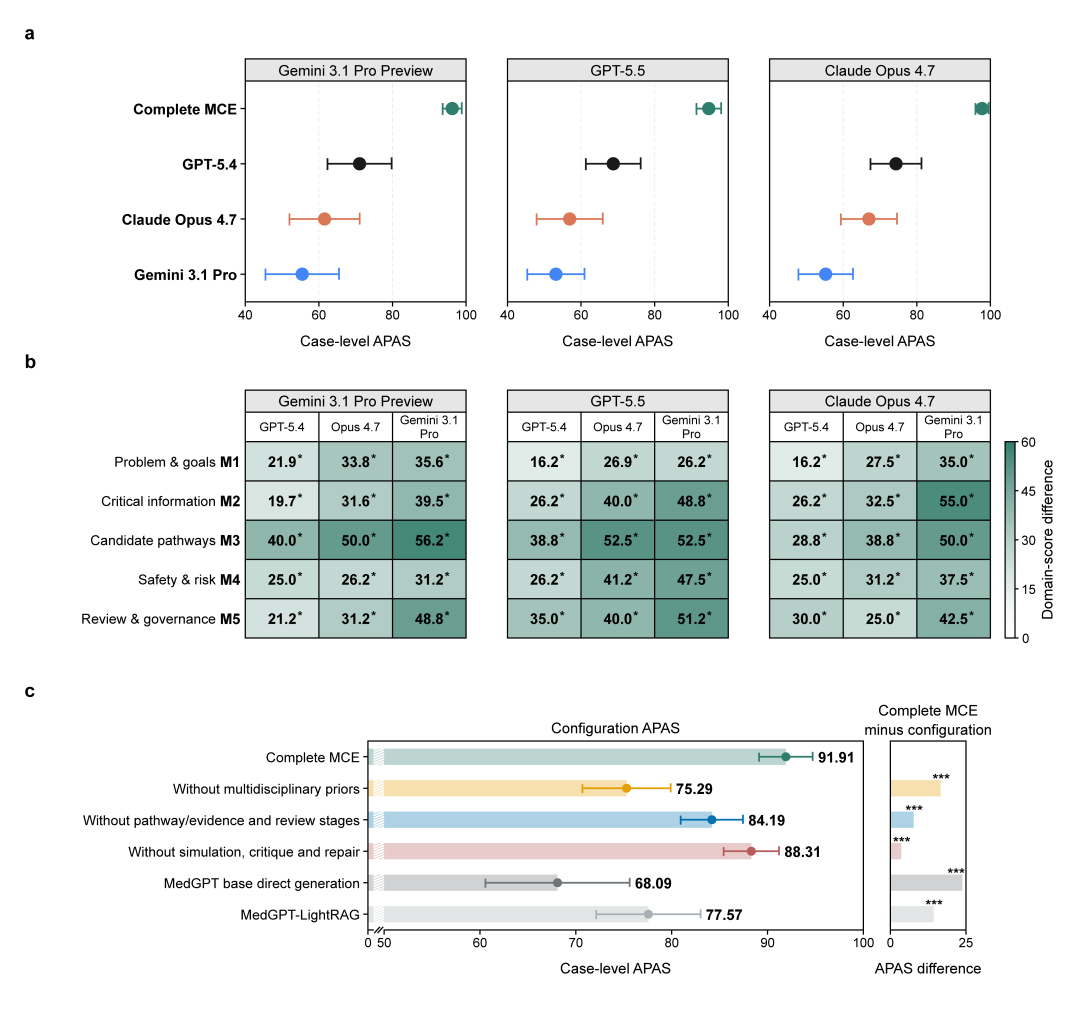
图示:在本研究的病例和评分条件下,完整MCE(MedGPT Clinical Explorer)生成的诊疗策略内容评分高于三种通用大模型对照,也高于删减功能或简化协作流程的版本
读到这里,你心里大概率会冒出一个问题:是不是底下的模型比人家大?
论文里专门做了消融实验(即像拆积木一样逐个拿掉系统模块,测试哪部分真正起作用)来回答这个问题:
把未来医生MedGPT的流程整个拆掉,只让底层的模型裸着直接回答,成绩立刻跌了将近24分;光是拿掉多学科会诊这一个模块,就掉了16分。
差距不在模型,在流程。
换句话说,AI赢了医生,不是因为它知道得多,而是因为它把医生看病的那套功夫——查资料、想方案、自己挑错、留后路,整个做成了一套可以自动运行的流程。
更值得关注的是,医生在获得未来医生MedGPT辅助后,综合决策评分从53.4提升至66.27,相对提高24.1%。
对于这一实验成果,包括中华医学会主委级专家、美国顶尖肿瘤医学专家在内的近10位一线临床权威给出了正面评价。
第一步:
把文献拆碎,拆到一条一结论
医生看复杂病例,第一件事是翻文献、查指南。
但这里有个很容易踩的坑:一篇肺癌论文里可能同时装了好几个结论,每个结论只对特定人群成立。要是整篇文献搜上来往病人身上一套,很可能把「对A人群有效」的证据用到了B身上。
未来医生MedGPT干了一件笨功夫,把文献在入库时就拆到最小颗粒:一条证据只记一个结论,并且标清楚它对什么样的病人管用、在什么情况下不算数、出自哪篇文献。
这里有一条铁规矩:证据只能由程序从原文中抄出来,模型只能引用,不能自己编。这是锁死AI幻觉的第一道结构性硬约束。
光肺癌这一个病种,团队就拆了一万三千多篇文献,涵盖临床指南与共识、随机对照试验、Meta分析(综合多项研究结果的统计分析)、真实世界研究(基于真实临床诊疗数据的研究)、药品说明书,以及十二个国际学术会议近三年的摘要。
一共生成了超过20万条结构化证据单元,归入23个类别,其中98.3%发表于2024至2026年。
证据与证据之间还建起43万条关系链,构成一张可检索的知识网络。
全库累计超过800万条证据单元。一个医生每天读一篇论文,要读四百多年才能看完。
这活儿干了好几年,不是搭个常规的RAG搜索(即先检索资料再让大模型生成回答的技术)就能追上的。
第二步:把病人也拆开,拆成动态状态表
病历上记的是事实。但系统要的不是静态的事实清单,而是这个人现在的状态:病到了哪一步、还有什么合并症(同时患有的其他疾病)、患者自己的治疗意愿是什么、哪些关键信息还没拿到。
每来一条新检查结果就更新一次,医生签字才作数。
接着,系统拿着那20万条证据往这个人身上挨个「套」。这不是简单的关键词匹配——证据本身够不够硬是一回事,对眼前这个具体的人管不管用是另一回事。
同一条指南推荐,放在肝功能正常的患者身上是首选,放到同时合并间质性肺病的患者身上,就可能是禁忌。
系统做的,是替医生把这层「对号入座」的苦力活先干了,把海量信息压缩成医生需要优先判断的几个关键问题。
第三步:方案先自己找茬,扛住了才能出门
这一步是整套流程里最狠、也最关键的部分。
首先,系统按病例组织最多6个相关专科的AI智能体,各自独立给意见。意见不合怎么办?不打圆场、不求平均,分歧原样保留。因为复杂病例的真正难点,往往就藏在这些分歧里。
随后,系统同时生成三类路径:一是标准路径,即指南和共识能撑住的方案,作为决策底线;二是前沿路径,当标准答案不够好时,从最新研究和学术会议中寻找更有利的候选方案,单独生成后与标准路径同台比较,接受同等审查;三是验证任务,明确指出做哪几项检查能最快判断哪条路更合适,并写明检查结果将如何改变方案。
方案出来了,还不急着交。
系统先按病人的真实状态造一个「虚拟患者」,把候选路径放进去模拟推演,逐项比较获益、风险、等待代价与可执行性。推演只使用研究中已有的真实数据,不做凭空填补。
推演完毕,进入五个维度的对抗式审查:
安全上,有没有踩到禁忌或红线;
尾部风险上,有没有小概率但后果严重的情况;
证据与剂量上,证据是否真的支持这个动作,剂量对不对;
时序与执行上,先后顺序和时间窗在真实临床中能不能落地;
边际价值上,新加的药物或检查真的能改变结果吗。
审查结果只有三种去向:保留、修复、淘汰。
挑错的模块只管挑,不管推荐。挑出一个问题就得改一处,能修就修,修不了就扔掉,扔掉的还得写明什么条件下能捡回来。
通常要扛过两到三轮审查才允许出方案——过不了,就不出。
有一个真实案例很能说明问题:一位患者刚入院时,某个候选方案只排在第三。
等了十天,两项检查结果回来:基因突变阳性,排名直接翻了过来,原来排第三的方案成了首选。
条件变了,结论就跟着变,方案是活的。
系统还有一个硬原则:绝不说「成功率87%」这种话。
很多AI产品一张嘴就是「方案A的成功率是87%」,听着精准,实际上没有任何研究能给出针对某一个具体个体的百分比。
未来医生MedGPT的做法是:需要量化时,引用与患者条件最相近的人群在真实试验中的数据,标明出处和证据编号。
数字可追溯、可复核,是否适用由接诊医生判断。
GPT-6出来不就追平了?
未来医生MedGPT真正的壁垒有三样:拆好的证据库、结构化的病人档案,以及每一个医生签过字的方案最终对照真实结果回来复盘的反馈闭环。
新模型不自带这三样。你可以把GPT-6接进来,把Claude接进来,换一个更强的底层模型。
但800万条拆到最小颗粒的证据单元它没有,动态更新的患者状态档案它没有,几年积累下来的「方案到结果」复盘数据它也没有。
反过来说,更强的模型接进来,这三样只会更强。
壁垒不在模型本身,在模型上面跑的这整套系统。前面消融实验里差出来的那24分,就是流程的价值,不是模型参数量的价值。
赢了医生是顺带的,
让医生变强才是目的
说到底,这套系统输出的东西,本来就不是拿来替代医生的,而是给医生审阅的决策材料。
在论文的人机协作维度下(该维度与前面的人机比较、模型横评评分口径不同),医生在没有任何辅助时平均得分53.40;提供与未来医生MedGPT相同知识库的检索参考后,分数涨到61.05。
而当医生直接审阅未来医生MedGPT输出的完整策略报告后再做判断,分数来到了66.27,比无辅助时涨了24%。
AI没有替代医生的判断,而是把医生的判断质量往上拉了一截。
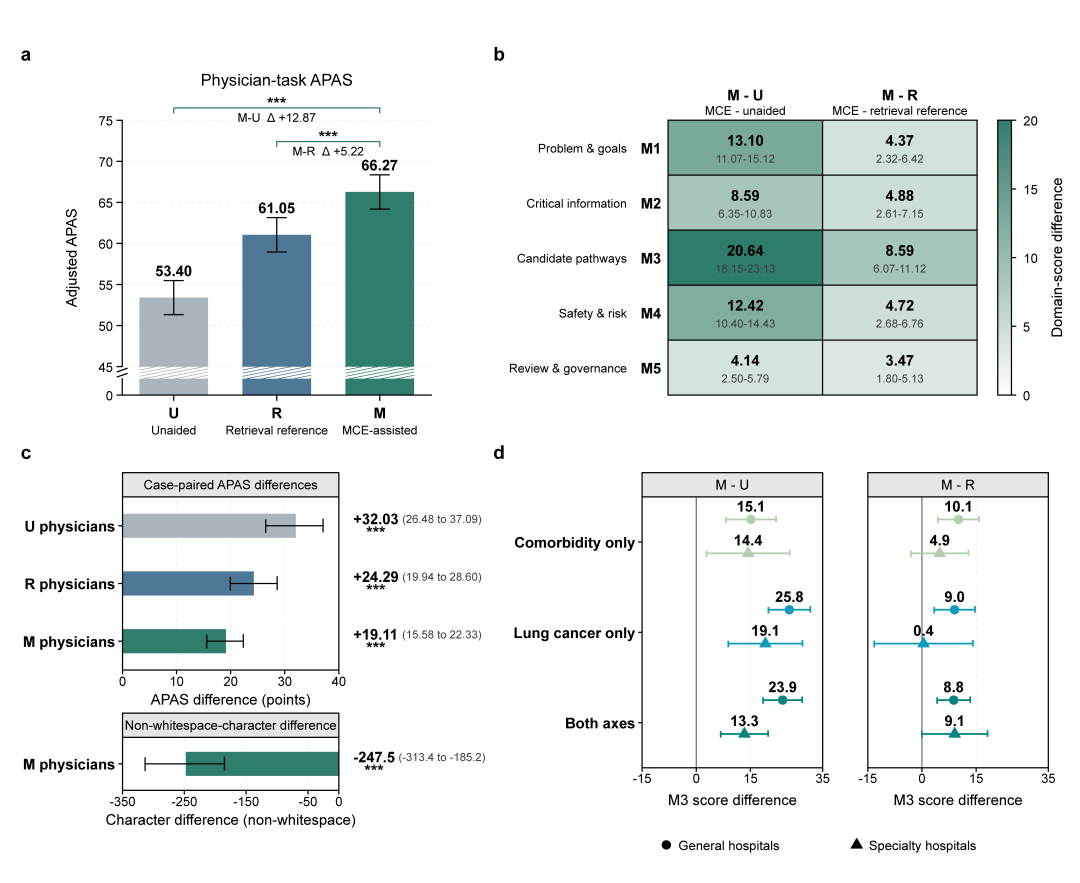
图示:相比无辅助或仅参考检索资料,MCE(MedGPT Clinical Explorer)辅助下的医生制定的诊疗策略总体得分更高,增益涵盖治疗备选路径、关键信息、安全风险和后续评估
对此,中美临床一线专家给出了高度一致的判断。
国内包括中国医学科学院肿瘤医院胸外科食管病区主任李印、山东省肿瘤医院乳腺病中心主任王永胜、四川大学华西医院胸外科学科带头人陈龙奇在内的多位中华医学会主委级专家均认可其临床实用价值,认为未来医生MedGPT正是一线医生迫切需要的医疗AI。
美国 UCSF Health 肿瘤外科主任 Robert Warren、美国「希望之城" 国家医疗中心乳腺肿瘤内科主任 Hope S. Rugo、有迈阿密地区最顶尖的前列腺癌放疗专家之称的Mark Pomper、加州大学旧金山分校血液肿瘤科荣誉主任 Marc Shuman 等顶尖专家也同步发声,肯定研究的行业价值与落地潜力。
本次实验PI、知名胸外科专家梁教授在实验后指出:「人工智能的核心不在于『智能』,而在于『人工』。」
前期人工梳理的资料是否全面、准确、翔实,直接决定了后续模型的效果。基础资料不完善,模型能力再强,也会出大量幻觉和判断偏差。
他还说得更直接:不学习AI的医生一定会被淘汰——不是AI淘汰医生,而是AI淘汰不会使用AI的医生。
未来医生创始人王仕锐引用张载的「横渠四句」,把这件事的使命归结为两层:「继绝学」,把顶级专家的判断力装进流程,让它可复制、可规模化;「开太平」,让医学知识本身更新得更快,并创造全新的医学知识。
中国的医疗现实摆在这里:优质资源高度集中,一个县城的主治医生面对复杂病例时能调用的信息和经验,跟协和的主任完全不在一个量级。
但如果有一套系统,能帮他把文献查到位、把方案比较清楚、把风险标出来、把退路想好,他做出的决策质量,就有可能向顶级专家靠拢。
这才是88比12这个数字背后,真正值得兴奋的事。